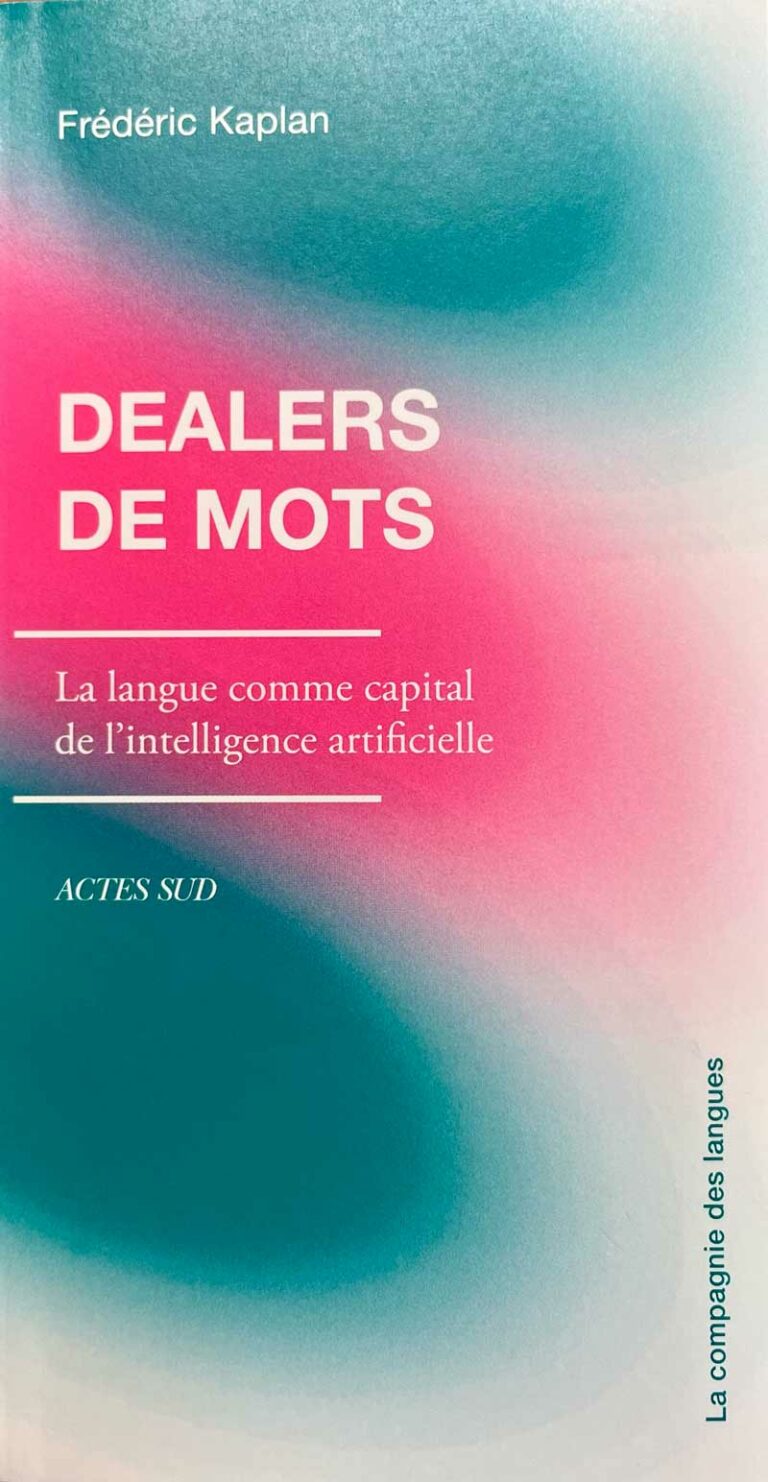
Parfois les mots vous manquent, parfois un texte vous semble trop long à lire par vous-même, vous souhaitez qu’on vous en propose un résumé. Vous ne regrettez pas d’utiliser des outils informatiques pour vous aider : la qualité des textes qu’ils produisent est extraordinaire.
Mais vous savez aussi que ces mots sont ceux des autres, volés sur des millions de pages jadis écrites.
Tous ces discours collectés, analysés, modélisés sont le capital accumulé par des entreprises qui désormais vous le revendent sous forme de services.
Comment en sommes-nous arrivés là ? Des premières enchères sur les mots aux modèles de langage géants : ce livre raconte comment le capitalisme linguistique s’est construit en vingt ans.
Frédéric Kaplan est professeur associé à l’EPFL (École polytechnique fédérale de Lausanne), où il occupe la chaire de Digital Humanities et président de la Time Machine Organisation, un réseau à but non lucratif réunissant plus de 600 institutions à travers le monde.
Ses travaux examinent comment l’intelligence artificielle remodèle les infrastructures de connaissance, la mémoire culturelle et les représentations à long terme du temps et de l’espace. Il se concentre sur la conception d’infrastructures de données à grande échelle et de modèles computationnels exploratoires, notamment par le développement de jumeaux numériques de systèmes culturels et urbains.
Il est l’auteur d’une dizaine de livres traduits en plusieurs langues et de plus de deux cents publications scientifiques.
Si l’auteur Frédéric Kaplan a bien un talent, s’est celui de trouver les mots justes pour expliquer les transformations que nous vivons actuellement, avec l’avènement de l’intelligence artificielle.
À travers l’histoire récente du capitalisme linguistique, de la monétisation des mots clés par Google au développement des derniers modèles de langages comme ChatGPT, Claude ou Gemini, l’auteur retrace vingt ans de captation linguistique, opérée par un petit nombre d’acteurs qui nous revendent ce même capital sous forme de service.
Au fil de la lecture, on découvre l’impact que pourrait avoir ces nouveaux outils sur l’évolution des langues dites « vivantes », traversées intrinsèquement par des experiences et des intentions, dans un monde ou des simulacres produits par les modèles dominants pourrait les condamner à une rigidité certaine.
Nous en avons déjà parlé sur ce blog : de plus en plus de chercheurs qui étudient l’impact des IA génératives sur nos fonctions cognitives publient leurs premières conclusions. Si nous manquons encore de recul, il semble se dégager un consensus sur l’impact réel des outils comme ChatGPT, Claude ou Gemini sur notre cerveau : délestage cognitif, baisse de l’activité cérébrale, re-modélisation neuronale, effet Google… Pour Kaplan, l’usage de ces IA peut influencer nos capacités d’énonciation et, indirectement, notre aptitude même à penser, qui se trouvent désormais entre les mains de ceux qui ont, patiemment et jalousement, accumulé les mots.
Car oui, chaque modèle porte une perception du monde en lien avec ses propres données et mécanismes de renforcement. La colonisation, la Révolution française, l’Empire napoléonien, tout évènement pourrait alors être narré de manière très différente selon les valeurs implicites intégrées dans les phases de renforcement. L’absence de transparence sur les données ayant servi à nourrir le modèle ainsi que les filtres appliqués lors de cette phase, rendent toute compréhension et analyse compliquée, voir impossible.


Dernières sorties, avis, extraits et résumés.
Mais alors que faire ? Si il ne semble pas réaliste de contraindre les grands acteurs du capitalisme linguistique à rendre publiques les données d’entraînement de leurs modèles nous dit l’auteur, il milite pour la constitution d’un capital linguistique public. Comment ? En engageant une politique tout aussi offensive de captation, visant à accroître la taille et la diversité des corpus ouverts, en poursuivant le développement de modèles de langage dont le code et les paramètres seront ouverts et publics, fondés sur des licences libres, le tout tournant sur une infrastructure décentralisée. Cette dernière proposition aurait également le double mérite de réduire le désastre environnementale lié à la construction de centres de données toujours plus grands tout en réenchantant l’opinion public.
L’essai de Frédéric Kaplan pose les bases d’un projet ambitieux qui vise à se réapproprier le capital linguistique comme bien commun.
La vente aux enchères des mots est la première invention qui permet de transformer le capital linguistique initial capté par Google, le mégatexte du web, en revenus financiers. Chaque année, Google gagne des centaines de milliards de dollars simplement en organisant la vente des mots à l’échelle planétaire. Le capital linguistique se transforme par ce biais en une manne financière qui propulse l’entreprise dans une autre dimension de croissance et lui permet de s’engager dans des projets en apparence distincts de toute logique commerciale directe. Vingt ans après l’invention d’AdWords, c’est encore le mécanisme de vente aux enchères des mots à l’échelle planétaire qui assure les revenus et la croissance de Google, à présent filiale d’un groupe nommé (de façon transparente) Alphabet. Au sein du groupe, les revenus de Google représentent plus de 99 % du chiffre d’affaires. Pour avoir un ordre de grandeur, en 2020, Google réalisait encore 180 milliards de dollars de chiffre d’affaires par an, soit 493 millions de dollars par jour, plus de 20 millions de dollars par heure. Essentiellement en vendant des mots (p.31)
En octobre 2019, le projet Google Books fête ses quinze ans d’activité et annonce avoir numérisé 40 millions de livres. Pour mettre ces chiffres en perspective, sur la base des estimations de la bibliothèque du Michigan, 1 million de volumes correspondent à 25,8 kilomètres d’étagères linéaires, 680 tonnes d’ouvrages à déplacer, 361 millions de pages à tourner, pour un trésor de 70 milliards de mots numérisés. En projetant ces chiffres sur les 40 millions de livres du projet Google Books, il est possible d’avoir un aperçu de l’importance de la logistique globale mise en œuvre par le projet : 1 032 kilomètres, 27 200 tonnes, 14,4 milliards de pages. En supposant qu’une page représente en moyenne une demi-heure de travail d’écriture, le capital linguistique accumulé représente l’équivalent de 7,2 milliards d’heures, l’équivalent de 820 millions d’années de travail. (p.44)
Imaginons que l’on veuille compléter la phrase suivante : « Il est allé à la… » Un linguiste traditionnel pourrait mobiliser une batterie de concepts : catégories grammaticales, structures syntaxiques, régularités morphologiques. Il pourrait théoriser que la préposition « à » appelle un complément de lieu, souvent un nom, parfois introduit par un article défini ou indéfini, et que le verbe « aller » induit un mouvement directionnel. Sans qu’aucune de ces notions ne soit invoquée, un calcul de probabilité statistique permet d’analyser que les mots les plus probables selon le contexte seront sans doute : « gare« , « maison« , « plage« , « mairie « . Un modèle fondé sur les probabilités lexicales peut prédire ce résultat sans savoir ce qu’est un lieu ni comment la syntaxe fonctionne au sens linguistique classique : il exploite simplement des co-occurrences massives observées dans les corpus. (p. 52)
D’une manière générale, une très large part des données utilisées semble être sous droit d’auteur. L’article du Washington Post révèle que le symbole « copyright » apparaît 200 millions de fois dans l’archive C4. Selon cet article, OpenAI, comme d’autres entreprises travaillant sur ce genre de capital téléchargé automatiquement, aurait choisi de ne pas documenter le contenu exact des données d’entraînement, même en interne, de peur de s’exposer à des formes de publication explicitement non autorisées sans le consentement des ayants droit. La stratégie est subtile. Si les données sont récupérées et consultées par les machines de manière autonome, mais jamais affichées et lues par un être humain, y a-t-il non-respect du droit d’auteur ? Pour les sociétés qui ne possèdent pas leur propre capital linguistique, il est nécessaire de naviguer sur une ligne de crête, la zone grise qui permet de récupérer les plus grands volumes de données sans s’exposer à trop de risques légaux. (p.72)
Anthropic, par exemple, a recruté en 2024 Tom Turvey, ancien directeur des partenariats du projet Google Books, avec pour mission explicite d’obtenir, aussi rapidement que possible, « tous les ouvrages du monde ». Le procédé mis en place pour atteindre cet objectif a été partiellement judiciaire, dont les documents ont été rendus publics. La procédure révèle notamment qu’Anthropic a acheté en masse des livres d’occasion, les a physiquement démontés, par découpage ou cisaillage, afin d’accélérer le processus de numérisation, puis a intégré les textes ainsi extraits dans l’entraînement de ses futurs modèles de langage. Les cadavres silencieux de ces millions de volumes, s’ils n’ont pas été détruits, s’entassent désormais sans doute dans une entrepôt, dissociés de leur matérialité d’origine, sacrifiés pour avoir nourri plus rapidement des modèles affamés de ressources linguistiques primaires. (p.169)
L’introduction des outils de rédaction découple l’aspect du texte écrit du temps de travail nécessaire pour le générer. Ce découplage, en érodant la pertinence des processus bureaucratiques de l’administration et du management, est susceptible de fournir parfois des gains de productivité, mais risque aussi d’accroître le sentiment de nihilisme associé à ces pratiques. À quoi bon lire le rapport d’un employé, s’il a été essentiellement rédigé par un service d’écriture ? À quoi bon produire ce rapport, si son supérieur produit lui-même sa réponse avec un système automatisé ? Quand la documentation du travail ne demande plus un effort d’écriture substantiel, le risque que le navire, privée d’un mécanismes de contrôle et de rétroaction, parte à la dérive est réel. (p.98)
Les grands journaux considèrent que leur matériel a été « volé » par un concurrent qui propose désormais des services directement en compétition avec les leurs. Les négociations pour trouver un accord de licence sur ce terrain durent pendant des mois. Mais le débat est devenu si conflictuel qu’il continue inévitablement devant la justice. Ces démarches s’inscrivent dans un mouvement plus large et une prise de conscience généralisée. En octobre 2023, dix-sept romanciers parmi les plus influents parmi eux, John Grisham, Jonathan Franzen, George R. R. Martin, décident de déposer une action contre OpenAI par l’intermédiaire de The Authors Guild. Selon eux, leurs mots ont été volés pour être maintenant revendus. Ces phrases qu’ils avaient lentement fait mûrir avant de les coucher sur papier sont à présent le simple carburant d’une gigantesque machine à écrire capable de produire une infinité de textes. (p. 106)
Plus un service est utilisé, plus il collecte de nouveaux mots, textes, contextes, séquences d’échanges. Ces contenus textuels sont inédits : ils ne se trouvent ni sur le web, ni sur les réseaux sociaux, ni dans les bibliothèques. Quel est alors le statut juridique de ces textes insérés volontairement par les utilisateurs pour faire fonctionner les interfaces ? Peuvent-ils être utilisés comme une source intarissable de carburant pour alimenter les moulins à textes ? (p. 108)
En juin 2023, Jensen Huang, directeur de Nvidia depuis trente ans, présente au Festival de Cannes sa vision du futur de la création des contenus personnalisés, « des milliards de publicités, chacune produite pour une seule personne ». Cette vision est sans doute encore en deçà de ce que la généralisation des outils d’écriture et des agents conversationnels permet d’envisager en matière de nouveaux territoires pour les industries de la publicité. Plutôt que d’associer optimalement des annonces aux contenus générés, pourquoi ne pas directement biaiser le résultat produit ? La publicité n’est jamais aussi efficace que quand elle est invisible : placement de produits dans la fiction, messages subliminaux. Si les marques deviennent des valeurs et que l’utilisation des services est gratuite, de subtiles alliances peuvent se mettre en place. (p. 120)
Toutes les prothèses, prolongement de notre cerveau, permettent d’agir avec plus de force et d’efficacité dans le monde, mais, irrémédiablement, conduisent simultanément à l’atrophie d’une compétence préalable, devenue obsolète ou, tout du moins, sous-optimale. Bernard Stiegler décrit ce phénomène comme une prolétarisation des savoirs : chaque fois qu’une technique prend en charge une faculté humaine, elle en accroît la puissance tout en en affaiblissant la maîtrise. Ce qui est délégué, externalisé, à la machine cesse progressivement d’être un savoir-faire. Les prothèses qui étendent notre intelligence risquent aussi de nous en déposséder si nous ne réinventons pas sans cesse notre façon de penser et d’agir avec elles.


Dernières sorties, avis, extraits et résumés.
Comment expliquer tant d’attention médiatique sur les coalitions et trahisons d’un si petit nombre de personnes ? Est-ce que ce microdrame incarne un combat entre deux « cultes » : ceux qui défendent l’accélération technologique et ceux qui, prévoyant l’inévitable apocalypse, font tout pour empêcher le pire d’arriver ? On peut douter que ce débat à mi-chemin entre la théologie et la science-fiction soit véritablement la force qui sculpte le devenir sociétal de ces technologies. Ne faut-il pas deviner derrière ces narrations shakespeariennes une autre typologie de déploiement dans laquelle ce ne sont pas primairement les positions éthiques ou morales des participants qui jouent le premier rôle, mais une force irréfrénable et encore peu comprise : le capital linguistique ? (p.131)
L’exploitation massive des modèles de langage pour produire ou transformer les flux linguistiques pose la question du devenir même des langues. À mesure que la proposition de textes générés par des agents artificiels augmente dans les systèmes culturels, un basculement d’un autre ordre pourrait se produire, une véritable transition de phase linguistique.
En physique, une transition de phase désigne le moment où un système change brutalement d’état : l’eau se met à bouillir, le métal devient magnétique, la matière passe d’un équilibre à un autre. Un phénomène analogue pourrait affecter les langues. Tant que la majorité des énoncés reste d’origine strictement humaine, les échanges linguistiques se déploient dans un milieu vivant, traversé par des expériences et des intentions. Mais lorsque les simulacres produits par les modèles deviennent dominants, la structure même de la langue risque de se refermer sur elle-même, évoluant dans un écosystème auto-entretenu. (p.153)
Le mécanisme de renforcement permet également de sculpter la mémoire historique du modèle, en l’amenant à interpréter préférentiellement certains événements du passé selon une perspective déterminée, et en structurant ainsi une lecture du monde qui sélectionne statistiquement ce qui doit être mis en avant, atténué ou reformulé. Une même période historique, la Révolution française, l’Empire napoléonien, la colonisation, peut être narrée de manière très différente selon les valeurs implicites intégrées dans les phases de renforcement. Les producteurs de modèles sont alors capables de construire une mémoire narrative orientée, où le passé est filtré par les préférences culturelles et leurs propres choix idéologiques. (p.158)
Il est possible d’identifier l’émergence d’une nouvelle prose caractérisée par une rythmicité singulière et des structures stylistiques récurrentes désormais reconnaissables.
L’une de ces formes, le diptyque pivot, regroupe des tournures rhétoriques du type : « ce n’est pas ceci… c’est cela », ou « Pas un… mais un ». La première proposition épouse le sens commun, tandis que la seconde le renverse. De la même manière, les énumérations ternaires, triptyques rythmiques, alignant successivement trois phrases courtes ou trois propositions, se sont elles aussi généralisées, produisant des effets de style à la fois harmonieux et efficaces.
Inévitablement, diptyques pivots et triptyques rythmiques apparaissent, parfois combinées dans une même phrase. Par exemple : « Ce n’est pas une simple transformation linguistique, c’est une mutation culturelle, sociale et intellectuelle. » L’expérience peut être répétée de multiples fois pour observer la sculpture statistique que provoque la médiation par le modèle de langage. (p.165)
Ces effets d’amplification sont également observables au niveau du vocabulaire : certains verbes, expressions, ou même signes de ponctuation ont connu une recrudescence inédite. En anglais, le verbe to delve (qui signifie « creuser » ou « approfondir ») s’est par exemple largement généralisé dans les résumés de publications scientifiques, sans qu’aucune explication autre que l’introduction de ChatGPT puisse être avancée. Il a été suggéré que le système de renforcement qui privilégie certaines formulations jugées plus pertinentes ou plus élégantes jouerait un rôle déterminant dans cette amplification, en plus des biais présents dans les corpus d’entrainement.Il semble par ailleurs que le verbe to delve soit plus fréquemment utilisé dans certains pays anglophones d’Afrique, où des annotateurs humains sont parfois recrutés pour effectuer ce travail d’évaluation des réponses du modèle, ce qui pourrait contribuer indirectement à sa surreprésentation. (p.166)
Illustration by Rose Wong
Une fois par mois, on décrypte l’actu Tech & Cyber.
Saisissez votre email